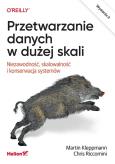
Przetwarzanie danych w dużej skali. Niezawodność, skalowalność i konserwacja systemów. Wydanie IICzego się nauczysz?Analizowania kompromisów między systemami transakcyjnymi (OLTP) a analitycznymi (OLAP)Definiowania wymagań niefunkcjonalnych: opóźnień, niezawodności, skalowalności i konserwowalnościDobierania modeli danych i języków zapytań: relacyjnych, dokumentowych i grafowychProjektowania schematów analitycznych typu gwiazda i płatek śniegu oraz oceny normalizacji i denormalizacjiStosowania event sourcingu i CQRS w architekturze systemów danychDobierania silników przechowywania i indeksów: B-drzew, LSM oraz indeksów wielokolumnowychWykorzystywania baz kolumnowych i chmurowych hurtowni danych do analityki na dużą skalęProjektowania wyszukiwania pełnotekstowego oraz indeksów wektorowych dla zastosowań AIWybierania formatów kodowania danych i podejść do ewolucji schematów (JSON, Avro, Protobuf)Projektowania przepływów danych między usługami: REST, RPC oraz architektur sterowanych zdarzeniamiImplementowania i porównywania strategii replikacji: z jednym liderem, wieloma liderami i bez lideraPlanowania shardingu, trasowania żądań oraz radzenia sobie z hot spotami i indeksami pomocniczymiRozumienia izolacji transakcji, sekwencyjności i problemów transakcji rozproszonych (2PC)Diagnozowania typowych problemów systemów rozproszonych: awarii częściowych, sieci i zegarówStosowania pojęć spójności, liniowości i konsensusu oraz roli usług koordynacjiProjektowania przetwarzania wsadowego i strumieniowego, w tym ETL, CDC, łączenia strumieni i odporności na błędyZrozum systemy danych od fundamentów po architekturę na skalę globalnąPrzetwarzanie danych w dużej skali stało się biblią w dziedzinie systemów rozproszonych. Niemal każdy poważny specjalista, jakiego znam, posiada jej egzemplarz.Will Wilson, CEO, AntithesisTa książka powinna być lekturą obowiązkową dla inżynierów oprogramowania.Kevin Scott, CTO, MicrosoftW erze chmury obliczeniowej, mikroserwisów i eksplozji danych każda nowoczesna aplikacja musi się mierzyć z wyzwaniami skalowalności, niezawodności i wydajności. Drugie wydanie kultowej książki Martina Kleppmanna, uzupełnione o współautorstwo Chrisa Riccominiego, to kompleksowy przewodnik po architekturze systemów danych od relacyjnych baz danych, przez rozproszone systemy NoSQL, po chmurowe hurtownie danych i przetwarzanie strumieniowe. Zaktualizowane wydanie uwzględnia najnowsze trendy: architekturę natywną dla chmury, indeksy wektorowe dla AI, silniki synchronizacji i oprogramowanie local-first.Książka prowadzi czytelnika przez cały ekosystem systemów danych od modeli przechowywania i indeksowania danych, przez replikację i sharding, po transakcje rozproszone i algorytmy uzgadniania konsensusu. Autorzy nie ograniczają się do opisu narzędzi tłumaczą, dlaczego systemy działają tak, a nie inaczej, i jakie kompromisy kryją się za każdą decyzją architektoniczną. Osobne rozdziały zostały poświęcone przetwarzaniu wsadowemu i strumieniowemu, filozofii systemów sterowanych zdarzeniami i etycznym aspektom pracy z danymi osobowymi.W książce:Modele danych i języki zapytańSilniki przechowywania danychReplikacja, sharding i transakcjeSystemy rozproszonePrzetwarzanie wsadowe i strumienioweArchitektura natywna dla chmuryEtyka i prawo
Ten produkt jest zapowiedzią. Realizacja Twojego zamówienia ulegnie przez to wydłużeniu do czasu premiery tej pozycji. Czy chcesz dodać ten produkt do koszyka?